2017年3月19日15:59:00
在第二个子任务当中已经学习到数据库的操作,不妨当前就修改源代码,将用户的查询结果存储到数据库当中。
源代码修改上,第一个需要修改的便是之前的“历史功能”,修改之前是使用字典保存“历史记录”,这样保存的记录在程序重启之后就被清空,但是使用数据库存储的话即便程序退出也能够保存历史记录。拟按照如下步骤来修正代码:
- 改动“历史查询”功能,使其可以正常访问数据库;
- 设计需要创建的数据表;
- 使用数据表来存储每次的查询记录;
- 优化:当用户查询时首先去数据表当中查询,如果数据表当中没有内容则通过API实时获取。
访问数据库
仿照SQLite Python tutorial中的例子在application.py当中添加访问数据库版本信息的新函数,传递给history.html进行渲染,测试成功:
def fetch_dbversion():
    conn = sqlite.connect('local_weatherdata.db')

    with conn:
            cur = conn.cursor()
            cur.execute('SELECT SQLITE_VERSION()')
            return cur.fetchone()
设计需要创建的数据表
当前数据表很简单,每一条天气记录只需要包含“城市”和“天气”,另外为了方便统计再添加“序号”。所以,创建语句可以编写为:
CREATE TABLE LocalWeather(Id INT, City TEXT, Weather TEXT)
对于Id这一列数据,想到每次插入时候其实并不知道当前的Id到多少了,最好可以让这个值自动更新,有没有办法呢?教程里面提到可以使用Id INTEGER PRIMARY KEY的方式:
CREATE TABLE LocalWeather(Id INTEGER PRIMARY KEY, City TEXT, Weather TEXT)
另外附加了下面的说明:
In SQLite, INTEGER PRIMARY KEY column is auto incremented. There is also an AUTOINCREMENT keyword. When used in INTEGER PRIMARY KEY AUTOINCREMENT a slightly different algorithm for Id creation is used.
这段话没有看懂,那到底是否需要使用“AUTOINCREMENT”关键字呢?自己使用SQLite测试,发现效果一样的。之后找到一篇不错的释疑文章SQLite AUTOINCREMENT : Why You Should Avoid Using It,其中讲到了为什么应该避免使用AUTOINCREMENT关键字。
使用数据表来存储每次的查询记录
2017年3月19日17:16:52
刚想到为了设计简单,不妨每次启动服务端的时候初始化数据库。
操作当中,遇到编码问题。
2017年3月25日09:59:05
继续。
几番测试之下发现自己使用的[u'杭州',u'小鱼']不对,因为在history.html当中渲染的变量是以字典的形式在访问,所以一直错误地以为是编码问题,现在将测试数据修改为{u'杭州':u'小鱼'}就可以正常显示了。下一步就是调试如何有效的访问数据库当中读取出来的数据。
本以为数据库当中读取出来的数据不能够通过字典访问,于是便进行了修改:
{% if history_record %}
  {% for key in history_record %}
    # 修改前
    <p style="text-align:center;"> {{ key }} {{ history_record[key] }} </p>
    # 修改后
    <p style="text-align:center;"> {{ key }} </p>
  {% endfor %}
{% else %}
但结果依然没有变好:
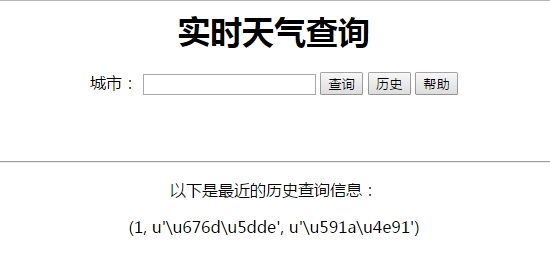
百思不得其解之后想起可以参考同侪的代码,在阅读了leilayanhui的代码之后意识到自己对于数据库返回数据的访问方式不甚了了,同时在模仿着将rows = cur.fetchall()更改为rows = cur.fetchone()之后竟然乱码情况消失了。这就有些奇怪了:数据库里面仅仅存储了一行数据,为什么使用fetchall与fetchone获取到的数据差别会这样大呢?
rows = cur.fetchall()对应的显示结果为:
rows = cur.fetchone()对应的显示结果为: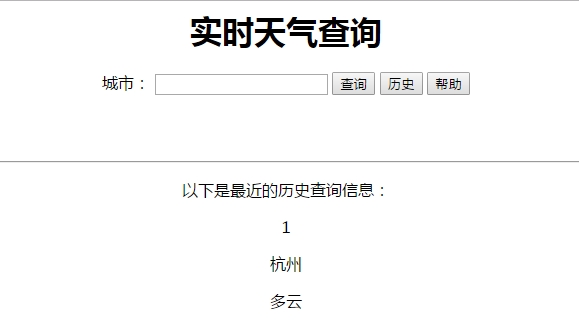
查询Python官方文档有如下说明:
To retrieve data after executing a SELECT statement, you can either treat the cursor as an iterator, call the cursor’s fetchone() method to retrieve a single matching row, or call fetchall() to get a list of the matching rows.
那么也就是说实际上也就是返回的单位不一样了, fetchone返回的结果对应单维列表,也就是一行的数据,而fetchall返回的结果对应了二维列表,也就是有多行数据。同时在hitory.html中是按照列表的方式去访问,看来其中是无法将整个一行按照单个变量的形式显示出来的。而这是否就是leilayanhui的代码当中为什么要通过索引去访问查询结果,并再次拼接起来的原因?
data2 = from_db(city)[1]
data3 = from_db(city)[2]
reslut = "%s: %s, %d℃" % (city, data2, data3)
his_list.append(reslut)
修改代码,测试通过。
SQLite 操作语句
- 创建表: CREATE TABLE friend(Id INTEGER PRIMARY KEY, Name TEXT)
- 插入行: INSERT INTO friend(Name) VALUES('tom');
- 查看表: SELECT * FROM friend;
- 查看列: SELECT Name FROM friend WHERE Id = 1;
- 删除行: DELETE FROM friend WHERE Id = 1;